sed, awk ja perl praktiliselt
sed sobib asendamiseks, awk väljade ja arvutuste jaoks ning perl keerukamaks mustritöötluseks.
Kiirülevaade
Eesmärk on minna edasi siis, kui grep, cut ja tr enam ei piisa: muuta ridu, arvutada väljade kaupa ja kirjutada lühike tekstiloogika.
| Käsk | Milleks | Mida tavaliselt näed |
|---|---|---|
sed | muuda ridu mustri järgi | ümber kujundatud tekstivoog |
awk | töötle välju ja veerge | valitud või arvutatud väljad |
perl | tee keerukam mustri- ja tekstiloogika | skripti või üherealise käsu väljund |
| faili muutmine | nõuab eraldi kuju | sisendfail ei muutu vaikimisi |
| süntaksiviga | käsk ei käivitu ootuspäraselt | mustri- või süntaksiveateade |
Tüüpilised algaja vead
- oodatakse, et
sedvõiawkmuudab faili kohe kohapeal - aetakse segi „esimene vaste real“ ja „kõik vasted real“
- kirjutatakse üherealine käsk, mille loogika on endalegi liiga segane
Üks asendus ja kõik asendused
sed 's/vana/uus/' asendab iga rea esimese vaste; lõppu lisatud g asendab kõik vasted sellel real. Sisendfail ei muutu: tulemus läheb standardväljundisse.
echo 'kass koer kass' | sed 's/kass/rebane/'
echo 'kass koer kass' | sed 's/kass/rebane/g'
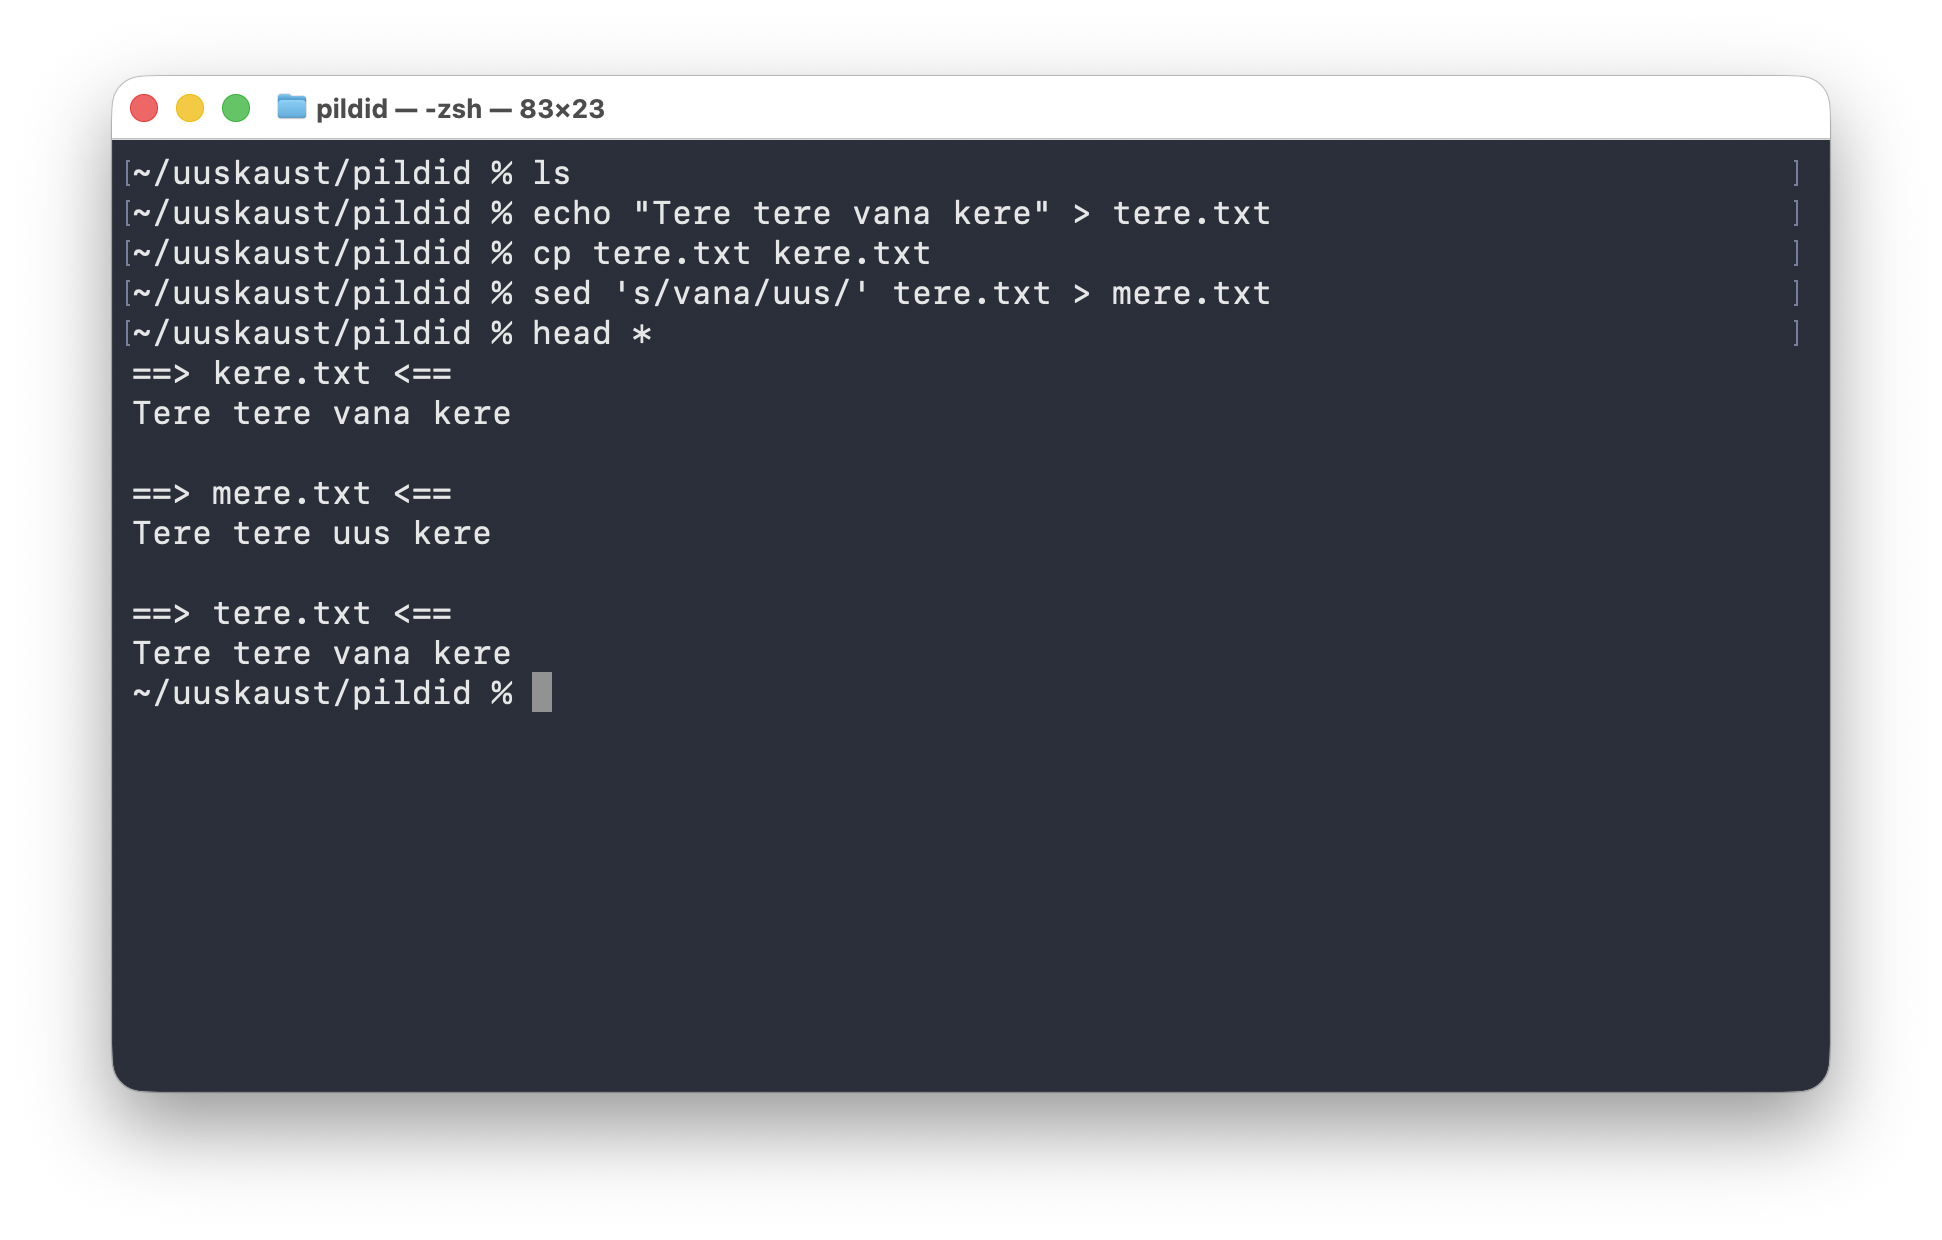
tere.txt kopeeritakse failiks kere.txt, seejärel tehakse käsuga sed 's/vana/uus/' uus fail mere.txt, ja head * abil võrreldakse kõigi kolme faili algust.Selle pildi loogika on järgmine:
echo "Tere tere vana kere" > tere.txtloob algse failicp tere.txt kere.txtteeb samast sisust koopiased 's/vana/uus/' tere.txt > mere.txtloeb failitere.txt, asendab esimese vaste ja kirjutab tulemuse uude failihead *näitab kolme faili algust üksteise järel
Ära suuna tulemust sisendfaili endasse: sed 's/vana/uus/' fail > fail tühjendab faili enne lugemist. Vali uus väljundfail. Kohapealse muutmise sed -i kuju erineb GNU ja macOS-i versioonis; kontrolli kohalikku käsiraamatut.
Üks asendus või kõik asendused
sed-i üks kõige tähtsamaid erinevusi on see, kas tehakse üks asendus või kõik asendused real.
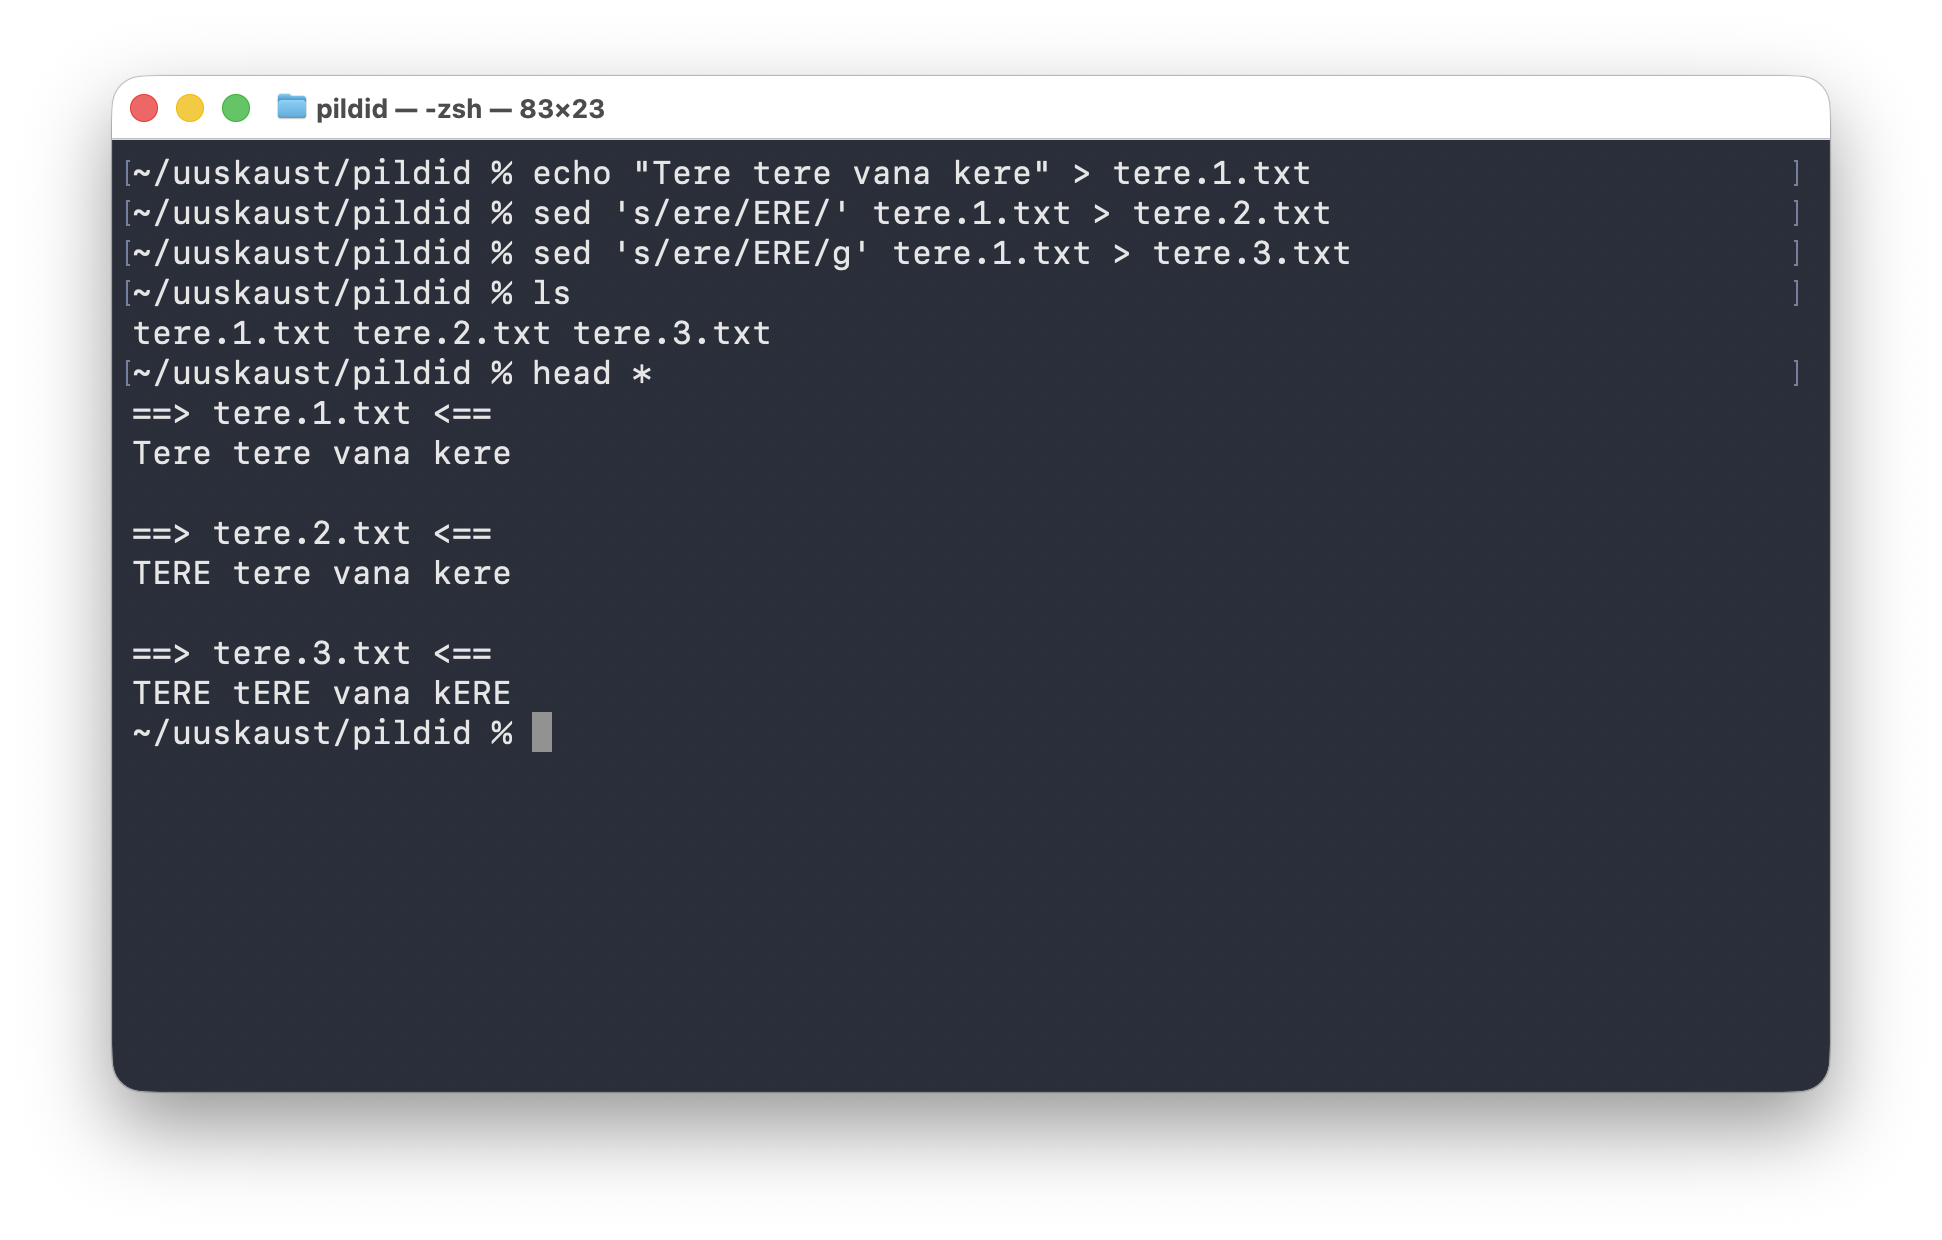
tere.1.txt tehakse kõigepealt käsk sed 's/ere/ERE/', mis muudab ainult esimese vaste, ja seejärel sed 's/ere/ERE/g', mis muudab kõik vasted.Selle pildi sees on näha kaks väga erinevat tulemust:
sed 's/ere/ERE/' tere.1.txt > tere.2.txtmuudab ainult rea esimese vastesed 's/ere/ERE/g' tere.1.txt > tere.3.txtmuudab kõik vasted samal realhead *näitab pärast kõiki kolme faili üksteise järel, nii et vahe on kohe nähtav
Rusikareegel on lihtne:
- ilma
g-ta muudetakse tavaliselt ainult esimene vaste real gtähendabglobal, ehk kõik vasted sellel real
awk -F: valib väljade eraldajaks kooloni. $1 ja $2 tähistavad esimest ja teist välja; komaga eraldatud väljad prinditakse vaikimisi tühikuga.
printf 'Mari:20\nJaan:21\n' | awk -F: '{print $1}'
printf 'Mari:20\nJaan:21\n' | awk -F: '{print $1, $2}'
Perli -e võtab koodi käsurealt, -p loeb ja väljastab read automaatselt ning -n jätab väljastamise sinu koodi otsustada. -F: määrab eraldaja, -a jagab rea massiivi @F, -l haldab reavahetusi; $F[0] on esimene väli.
echo 'kass koer kass' | perl -pe 's/kass/rebane/g'
printf 'Mari\nJaan\n' | perl -ne 'print if /Ja/'
printf 'Mari:20\nJaan:21\n' | perl -F: -lane 'print $F[0]'
Edasijõudnule: algarvud regulaaravaldisega
Järgmine näide ei ole algarvude leidmiseks kõige praktilisem, kuid näitab hästi, kui võimsad võivad Perli üherealised käsud olla:
seq 2 200 | perl -nlE 'say if ("a" x $_) !~ /^(aa+)\1+$/'
See kuju on siin meelega võimalikult lihtne. Kuna alustame vahemikku 2-st, ei pea me eraldi 0 ja 1 juhtumeid regexis välja filtreerima.
Mõte on selline:
- iga arv teisendatakse ajutiselt ühe tähe korduseks, näiteks
7muutub kujuleaaaaaaa - regex proovib leida, kas see rida koosneb mingist väiksemast plokist, mida saab mitu korda korrata
- kui saab, siis arv ei ole algarv
- kui ei saa, siis prinditakse arv välja
See tähendab sisuliselt: „Prindi ainult need arvud, mida ei saa kirjutada kujul m * n, kus mõlemad on suuremad kui 1.“
Praktilises skriptis oleks tavaliselt mõistlikum kasutada tavapärast jaguvuskontrolli, aga ühe rea triki või loengu-näite jaoks on see väga meeldejääv.
Minitest
- Asenda reas üks sõna teisega.
- Võta välja kooloniga eraldatud faili esimene väli.
- Prindi
awkabil ainult teine veerg. - Filtreeri
perl -neabil välja ainult need read, kus on kindel muster. - Tee
perl -peabil globaalne asendus kogu sisendi ulatuses.
Peatüki täisspikker
Töövood
Eesmärk
kasuta sed lihtsaks asenduseks, awk väljade jaoks ja perl siis, kui vajad tugevamat regulaaravaldiste loogikat
Põhikujud
echo 'kass koer kass' | sed 's/kass/rebane/'asenda esimeneecho 'kass koer kass' | sed 's/kass/rebane/g'asenda kõikprintf 'Mari:20\nJaan:21\n' | awk -F: '{print $1}'võta esimene väliprintf 'Mari:20\nJaan:21\n' | awk -F: '{print $1, $2}'võta kaks väljaecho 'kass koer kass' | perl -pe 's/kass/rebane/g'asenda Perligaprintf 'Mari\nJaan\n' | perl -ne 'print if /Ja/'filtreeri Perliga
Olulisemad lipud, märgid ja kiirnupud
s/vana/uus/üks asendus/gkõik vasted-F:koolon väljade vahel$1esimene väli$2teine väli-pe/-neread läbi